AIやデータサイエンス、品質管理の現場で統計学の重要性が高まるなか、多くの学習者が最初につまずく壁が「確率密度関数(probability density function:PDF)」です。1や2といった離散的な数値とは違い、身長・気温・時間などの連続的なデータを扱う際には、関数そのものの値ではなく積分で求めた面積を確率として扱う仕組みが不可欠になります。
名前がよく似た「確率関数」や「確率分布関数」と混同してしまったり、なぜ積分の計算が登場するのかイメージしづらかったりする方も少なくありません。連続型確率変数では「ぴったり特定の1点になる確率」がゼロになるため、一定の区間における確率の濃さ(密度)を関数で表し、その範囲の面積を求めるアプローチがとられます。
ここからは、確率密度関数の本質的な意味をはじめ、積分を使ってグラフの面積から確率を算出する具体的な計算手順、さらには混同しやすい「確率分布関数」「確率関数」との決定的な違いまで丁寧に解説します。統計学の基礎をしっかり固めるために、まずは基本定義から詳しく見ていきます。
【基本定義】確率密度関数とは何か?面積が確率になる理由を紐解く
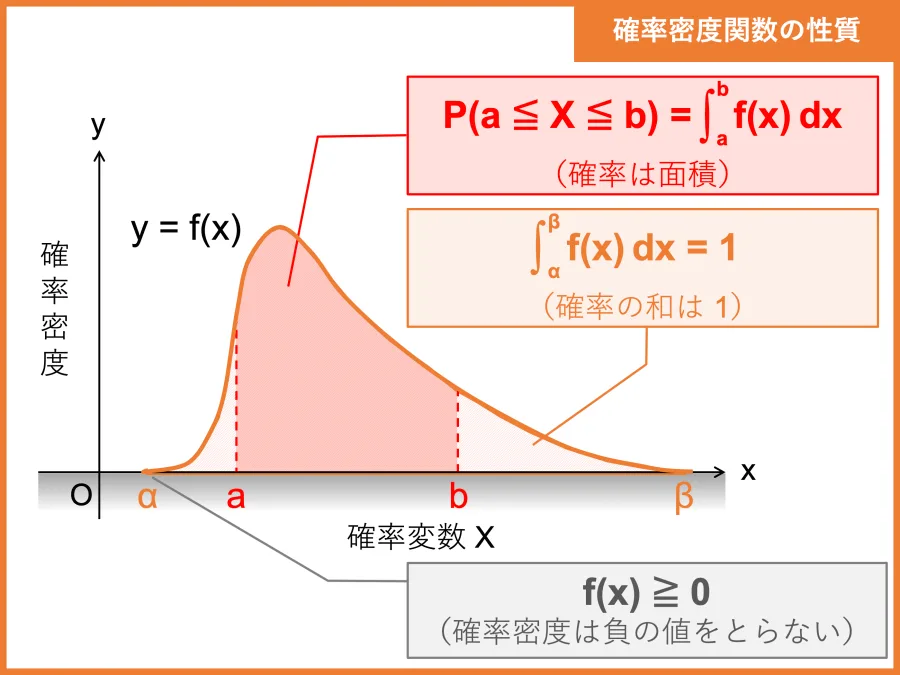
確率密度関数(英: probability density function、略称:PDF)とは、確率論および統計学において、連続型確率変数がある範囲の値をとる際の「確率密度(確率の濃さ)」を記述する関数です。たとえば、成人男性の身長やスマートフォンのバッテリー持続時間、部品の誤差のように、小数点以下まで無限に細かく測定できる数値(連続データ)を扱う場面で用いられます。
サイコロの出目(1〜6の整数)のような離散データであれば、「3が出る確率は6分の1」とピンポイントの値に対して確率を割り当てられます。しかし、連続型確率変数では「身長がぴったり170.0000…cmである確率」は限りなく0に近づくため、特定の1点に確率を定めることができません。
そこで活躍するのが確率密度関数です。関数 $f(x)$ の値そのものは確率ではなく、あくまで「その値の周辺にデータがどれくらい密集しているか」という密度を表します。公式な定義においても、確率密度関数の値域は常に非負の実数($f(x) \ge 0$)であり、定義域全体を積分すると合計が必ず1になるよう設計されています。
【グラフと積分】面積から確率を算出する具体的な求め方
確率密度関数から実際の確率を求めるには、グラフの「面積」を計算します。単変数の確率密度関数を平面上のグラフに描き、横軸($x$軸)に確率変数の値、縦軸($y$軸)に確率密度 $f(x)$ をとった場合、求めたい範囲の下限値 $a$ と上限値 $b$ の垂直線、関数の曲線、そして $y = 0$(横軸)の直線で囲まれた領域の面積が、そのまま「$x$ が $a$ 以上 $b$ 以下になる確率」に一致します。
曲線で囲まれた複雑な図形の面積を正確に求めるための数学的手法が「定積分」です。連続型確率変数 $X$ が区間 $[a, b]$ の値をとる確率 $P(a \le X \le b)$ は、確率密度関数 $f(x)$ を用いて次の数式で表されます。
$$P(a \le X \le b) = \int_a^b f(x) \, dx$$
たとえば、0から1までの値を均等にとる一様分布の確率密度関数は $f(x) = 1$($0 \le x \le 1$)です。このとき、$x$ が $0.2$ から $0.5$ の間に入る確率を求めたい場合は、底辺が $0.5 - 0.2 = 0.3$、高さが $1$ の長方形の面積を計算すればよいため、積分計算の結果は $0.3$(30%)となります。このように、関数の高さ(確率密度)に幅(区間)を掛け合わせて面積を出すイメージを持つと、積分の意味が直感的に理解できます。
【徹底比較】確率密度関数・確率関数・確率分布関数の違いとは?
統計学の参考書やWeb記事を読み進めるうえで、多くの人が混乱するのが「確率関数」「確率分布関数」「累積分布関数」といった似た名称の用語です。特に「確率分布関数(probability distribution function)」や「確率関数(probability function)」という用語は、文脈や書籍によって何を指しているか定義が曖昧なケースがあり、確率論研究者や統計学者の間でも「標準的ではない用語」とみなされる場合があります。
実務や試験で誤解を防ぐためには、対象となる確率変数が「離散型」か「連続型」か、そして「区間(または点)の確率」と「累積の確率」のどちらを表しているかで整理するのが確実です。
| 用語名 | 対象の確率変数 | 関数が表す意味と性質 | 実務・学習上の注意点 |
|---|---|---|---|
| 確率密度関数 (PDF) |
連続型確率変数 (身長、時間、気温など) |
値の「確率密度」を表す。区間 $[a, b]$ で積分した面積が確率になり、全区間の積分値は1。 | 関数 $f(x)$ の値自体は確率ではないため、1を超える場合もある。 |
| 確率質量関数 (PMF / 確率関数) |
離散型確率変数 (サイコロの目、人数など) |
特定の値 $x$ をとる確率そのものを表す。すべての値の確率を足し合わせると1になる。 | 一般的に「確率関数」と呼ぶ場合は、この離散型の確率質量関数を指すことが多い。 |
| 累積分布関数 (CDF) |
連続型・離散型の両方 | 確率変数が「ある値 $x$ 以下になる累積確率」$F(x) = P(X \le x)$ を表す関数。 | 連続型の場合、確率密度関数を $-\infty$ から $x$ まで積分したものに一致する。 |
| 確率分布関数 | 文脈により異なる (定義が曖昧) |
「累積分布関数」の別名として使われる場合と、確率分布全般の関数を漠然と指す場合がある。 | 専門家の間でも定義が統一されていないため、論文や実務ではPDFやCDFと明記するのが無難。 |
表の通り、離散データを扱う「確率質量関数(確率関数)」では代入した値がそのまま確率になりますが、連続データを扱う「確率密度関数」では積分して面積を求めなければならない点が決定的な違いです。また、確率密度関数を左端からある地点 $x$ まで積分して面積を足し上げたものが「累積分布関数(CDF)」であり、累積分布関数を微分すると元の確率密度関数に戻るという表裏一体の関係にあります。
【代表的な応用】正規分布の確率密度関数と期待値・分散の導出
統計学で最も頻繁に登場する連続型確率分布が「正規分布(ガウス分布)」です。テストの偏差値や製造ラインの製品誤差、自然界の測定データなど、あらゆる現象がこの分布に従います。平均を $\mu$、分散を $\sigma^2$ としたとき、正規分布の確率密度関数は次の数式で定義されます。
$$f(x) = \frac1\sqrt2\pi\sigma^2 \exp\left( -\frac(x - \mu)^22\sigma^2 \right)$$
この関数をグラフに描くと、平均 $\mu$ を頂点として左右対称に広がる釣鐘型(ベルカーブ)の曲線になります。標準偏差 $\sigma$ が小さいほど山は高く鋭くなり、$\sigma$ が大きいほどなだらかに広がりますが、どの正規分布であっても横軸と曲線に囲まれた全体の面積は常に1に保たれます。
加えて、確率密度関数を用いることで、データ全体の重心を表す「期待値(平均)$E[X]$」や、データの散らばり具合を示す「分散 $V[X]$」も積分で厳密に計算できます。
- 期待値 $E[X]$ の求め方: 確率変数の値 $x$ に確率密度 $f(x)$ を掛けて全区間で積分します($E[X] = \int_-\infty^\infty x f(x) \, dx$)。
- 分散 $V[X]$ の求め方: 平均からの偏差の2乗 $(x - \mu)^2$ に確率密度 $f(x)$ を掛けて全区間で積分します($V[X] = \int_-\infty^\infty (x - \mu)^2 f(x) \, dx$)。
離散型確率変数で「値 × 確率」を総和($\Sigma$)で足し合わせていた計算を、連続型ではインテグラル($\int$)による積分に置き換えているだけだと捉えると、数式の構造が明快に見えてきます。
【プロの結論】データ分析で確率密度関数を正しく使いこなすための視点
統計学や機械学習の現場において、確率密度関数は単なる数学の公式ではなく、手元のデータがどのような構造で発生しているかをモデル化するための基盤です。ここで最も重要なのは、「確率密度関数の縦軸の値($f(x)$)を確率と誤認しないこと」に尽きます。
たとえば、区間 $[0, 0.5]$ の一様分布では、定義域全体の面積を1にするために高さ(確率密度)が $f(x) = 2$ となります。「確率が200%になるのはおかしい」と戸惑う初心者は少なくありませんが、これは幅が $0.5$ と狭いために密度が濃くなっているだけであり、実際の確率は必ず「面積(高さ × 幅)」で評価されます。
また、正規分布をはじめとする複雑な確率密度関数は、手計算で初等関数として積分できないケースがほとんどです。そのため、実務ではあらかじめ積分値が計算された「標準正規分布表」を参照するか、Python(SciPyなど)やRといった統計解析ツールの累積分布関数(CDF)を用いて区間面積を算出するのが鉄則となります。数式の暗記に終始するのではなく、「グラフのどの部分の面積を求めているのか」を常に視覚化して捉えることが、統計モデルを正しく解釈する最大の武器になります。
【確率密度関数】に関するよくある質問(FAQ)
Q1:確率密度関数の値が1を超えることはありますか?
A1:はい、1を超えることはあります。確率密度関数が表すのは「確率そのもの」ではなく「確率の密度(グラフの高さ)」だからです。データの取りうる範囲(横幅)が1より狭い場合、全体の面積を1に保つために縦軸の高さが1より大きくなることがあります。
Q2:連続型確率変数において、特定の1点(例:ちょうどx=5)の確率が0になるのはなぜですか?
A2:グラフの面積で確率を計算するためです。特定の1点では区間の幅が0になるため、どれだけ高さ(確率密度)があっても「幅0 × 高さ = 面積0」となり、数学上の確率は0と定義されます。そのため、連続型では必ず「4.9以上5.1以下」のように幅を持たせた区間で確率を求めます。
Q3:確率密度関数と累積分布関数はどのように使い分ければよいですか?
A3:データの分布の形状(どこにデータが集中しているか、山がいくつあるかなど)を視覚的に把握したいときは「確率密度関数」を使います。一方、「上位10%に入る基準値を知りたい」「ある値以下になる確率をすぐに求めたい」といった場合は、面積がすでに計算されている「累積分布関数」を使うのが効率的です。
確率密度関数は、連続的なデータを扱う現代の統計解析やAIモデルの予測確率を裏付ける中核概念です。2026年現在、ノーコードの分析ツールや生成AIによって複雑な統計計算を瞬時に実行できる環境が整っていますが、出力されたグラフの縦軸が「確率」なのか「確率密度」なのかを見極めるリテラシーは、分析者自身の判断に委ねられています。
今後データ分析や統計検定の学習を進める際は、数式の展開だけを追うのではなく、必ず横軸(確率変数)と縦軸(確率密度)のグラフを描き、「求めたい確率はどの範囲の面積に該当するのか」を確認する習慣をつけてください。離散型の確率関数との違いと、積分・累積分布関数とのつながりを押さえておけば、応用的な確率分布や仮説検定の理解もスムーズに進められます。